

Blog
Guías prácticas sobre crawling SEO, visibilidad en buscadores con IA y SEO técnico. De etiquetas canonical a presupuesto de rastreo, con ejemplos reales.
Cómo verificar el tráfico de Googlebot con rangos de IP
Verifique el tráfico de Googlebot usando los archivos JSON oficiales de rangos de IP de Google, detecte bots falsos por su IP y proteja su presupuesto de rastreo sin bloquear visitas de búsqueda reales.
Por qué Google ignora tu sitemap y cómo diagnosticarlo
Enviaste un sitemap XML limpio y Google sigue dejando páginas fuera del índice. Un sitemap es una pista, no una orden. Estas son las razones reales por las que Google lo ignora y cómo diagnosticar cada una con tu propio rastreo.
Pasar de Screaming Frog a Seodisias: guía práctica de migración
Una guía paso a paso para usuarios de Screaming Frog que se mudan a Seodisias: qué se mantiene igual, qué ganas y cómo montar tu primer rastreo sin chocar con un tope de URLs ni pagar una licencia anual.
Como comprobar si los rastreadores de IA ven su contenido
Los rastreadores de IA leen el HTML crudo, no su JavaScript renderizado. Asi comprueba, en pocos comandos, si su contenido es visible para ellos.
GEO por motor: cómo ChatGPT, Perplexity y Google AI deciden cada uno qué citar
La mayoría de los consejos de GEO tratan la búsqueda con IA como si fuera una sola cosa. No lo es. ChatGPT, Perplexity y Google AI Overviews recuperan y citan fuentes de forma distinta, y optimizar para uno no equivale a optimizar para todos. Un desglose motor por motor.
Cómo encontrar los crawlers de IA en sus logs del servidor: quién visita, cuánto y cómo verificarlo
GPTBot, ClaudeBot, PerplexityBot y compañía ya están en sus access logs. Cómo encontrarlos, distinguir bots reales de impostores y decidir qué hacer, si hay que hacer algo.
RFC 10023: los dominios ya pueden decir "en venta" en el propio DNS
La nueva convención _for-sale permite que un dominio declare, de forma legible por máquinas, que está en venta. Cómo funciona el registro, qué cambia para el mercado de dominios y qué no hace por su posicionamiento.
Open Knowledge Format (OKF): qué es y por qué no es un archivo SEO
El Open Knowledge Format de Google empaqueta conocimiento para agentes de IA en Markdown plano. Cómo funciona, cómo crear uno y por qué no es una señal de ranking.
Habilidades de Agentic SEO para 2026: qué conviene aprender de verdad
Lo agéntico está en todas partes, pero pocos dicen qué significa para sus propias habilidades. Aquí tiene qué destrezas de SEO ganan peso, cuáles son realmente nuevas y una forma de bajo riesgo de aprenderlas sin correr detrás de la exageración.
¿Demasiadas páginas delgadas que compiten entre sí? Cómo decidir cuáles podar
Cuando varias de sus páginas persiguen la misma consulta, reparten su autoridad en lugar de sumarla. Aquí tiene cómo encontrar páginas que se canibalizan y páginas delgadas con un rastreo, más un marco de decisión claro para cuándo borrar, redirigir, poner en noindex, consolidar o canonicalizar cada una.
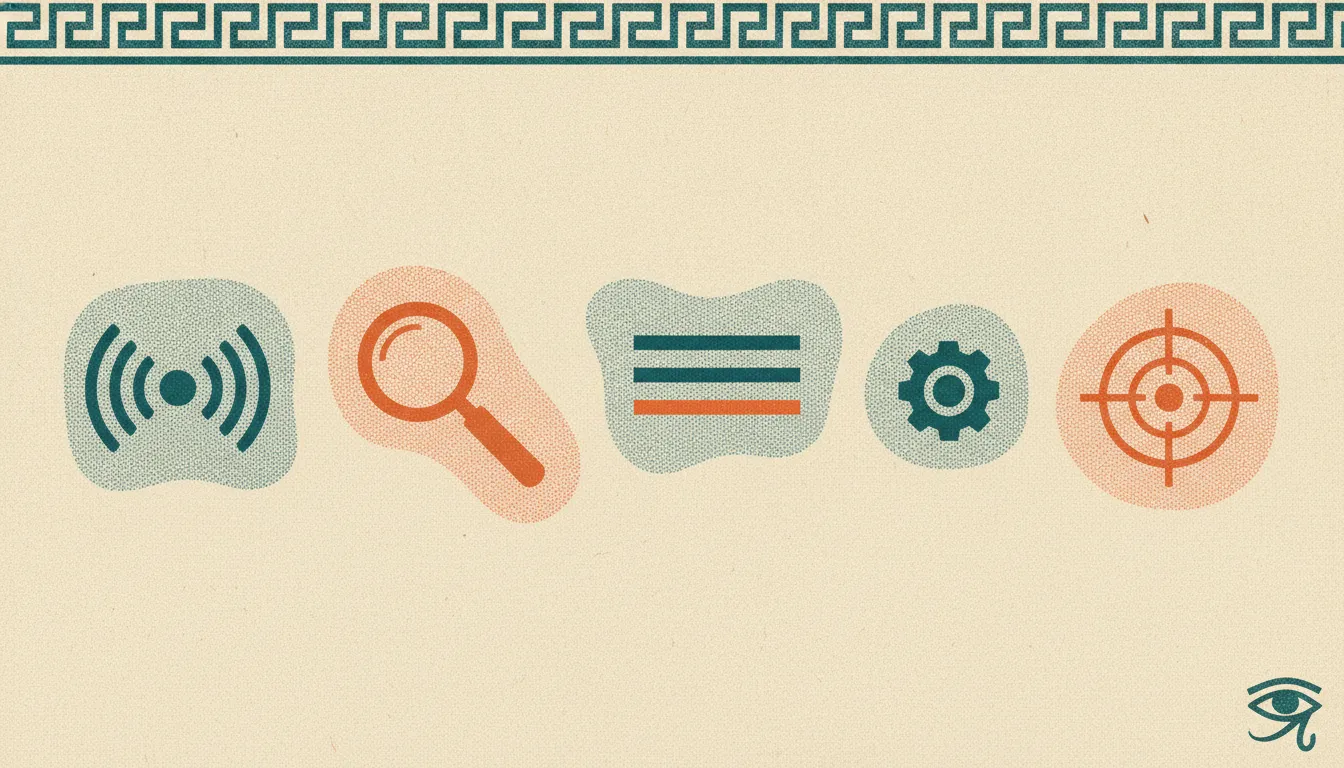
El panorama de herramientas SEO con IA en 2026: un mapa de cinco categorías, no otra lista de moda
La IA cambió lo que es una herramienta SEO. Estas son las cinco categorías que ahora importan: qué hace cada una, dónde encaja todavía un crawler técnico sencillo y por qué ninguna herramienta salva el mal contenido.
Seodisias es gratis para siempre. Esto es lo que estamos construyendo para equipos.
El crawler de escritorio gratuito no va a ninguna parte. Junto a él estamos construyendo planes de pago para autónomos, equipos y agencias: informes en la nube, marca blanca, recordatorios, cruce con Search Console y más. Todavía sin precios. Díganos qué le importa y ayúdenos a priorizar.
Crawler SEO en la nube vs de escritorio: es una decisión de arquitectura, no una guerra de marcas
Los crawlers en la nube como DeepCrawl y los de escritorio como Screaming Frog no compiten por funciones. Son dos arquitecturas. Cómo elegir según el tamaño del sitio, la privacidad de los datos, el equipo y el presupuesto.
Screaming Frog vs Sitebulb en 2026: la diferencia real está en el flujo de trabajo, no en las funciones
Screaming Frog es un banco de trabajo de datos; Sitebulb, un auditor guiado. Cuánto cuesta realmente cada uno, dónde gana cada herramienta, quién debería pagar por cuál y cuándo un crawler gratuito cubre todo el trabajo.
Precio de Screaming Frog en 2026: lo que cuesta de verdad y las alternativas gratuitas que sí escalan
Cuánto cuesta Screaming Frog, qué le da realmente el plan gratuito de 500 URL, por qué las descargas pirateadas son una trampa y qué crawlers gratuitos y legales siguen funcionando pasado el límite.
Crawlers SEO de código abierto en 2026: alternativas autoalojadas a Screaming Frog
Los crawlers SEO cuyo código es realmente abierto: LibreCrawl, Open SEO Crawler, Apache Nutch y los frameworks que hay detrás. Qué le aporta de verdad el código abierto, qué entrega a cambio y cuándo supera a una herramienta de escritorio gratuita.